Modern yapay zekânın en büyük darboğazı modelin zekâsı değil, verinin fiziksel hareketidir. Bir GPT mimarisinin katmanları boyunca akan hesaplamanın kalbindeki self-attention operasyonu, kâğıt üzerinde zarif bir matris çarpımı ve yumuşatma fonksiyonundan ibarettir; ancak pratikte, işlemcinin üretebildiği ham hesap gücünün onlarca katını tek başına tüketen bir bellek erişim canavarına dönüşür. Bu makale, o canavarın anatomisini çıkarıyor: O(N²) karmaşıklığının cebirsel kökeninden, bellek duvarının 1995’te adını konmuş fiziksel sebebine; softmax’ın sayısal olarak neden blok blok parçalanamaz göründüğünden, onu istemci (streaming) hale getiren online softmax türetmesine; ve FlashAttention’ın GPU’nun on-chip SRAM’ini algoritmanın birincil tasarımıyla barıştırarak bu duvarı nasıl aştığına kadar — tüm formüller, sabitler ve IO alt sınırlarıyla birlikte.
Bu, WebTuring Principia’nın ilk yazısıdır. Principia, haber değil kalıcı mühendislik birinci ilkeleri yayınlar: burada yazılanlar gündemle eskimez, çünkü fizik ve asimptotik karmaşıklık gündemi takip etmez.
Attention’ın Cebiri: Formüller ve Karmaşıklık Sınıfları
Bir transformerdaki N adet token, her katmanda d boyutlu (head başına d_k) vektörlerle temsil edilir. Girdi temsilleri X ∈ ℝN×d_model olmak üzere, sorgu (query), anahtar (key) ve değer (value) matrisleri learned projeksiyonlarla üretilir:
Ölçekli nokta-işaret attention tanımı (Vaswani ve ark., 2017):
Bu tek satır, üç ayrı maliyet nesnesi içerir. Skor matrisi S = QKT/√d_k ∈ ℝN×N, satır bazında softmax P = softmax(S) ∈ ℝN×N ve çıktı O = PV ∈ ℝN×d_k.
Zaman karmaşıklığı: QKT çarpımı head başına 2N²d_k kayan-nokta işlemi (FLOP) gerektirir; PV çarpımı bir o kadar daha. Toplam:
Softmax’ın kendisi (üs, toplam, bölme) satır başına O(N) olmak üzere toplamda O(N²) FLOP’tur — yani iki kat daha küçük mertebede, d_k ≥ 1 için matris çarpımları baskındır.
Bellek karmaşıklığı: Asıl sorun burada. S ve P matrislerinin her biri N² eleman tutar. Bu, attention’ın depolama maliyetinin token sayısının karesiyle büyüdüğü anlamına gelir:
Neden √d_k ile ölçekleme? Varsayalım ki q ve k bileşenleri bağımsız, ortalaması 0, varyansı 1 rastgele değişkenler. O hâlde q·k = Σi=1d_k qiki toplamının varyansı d_k’dır (her terimin varyansı 1, kovaryanslar sıfır). Yani nokta-işaretin standart sapması √d_k ile büyür; bu değer softmax’a girince üstel fonksiyon doygunluğa sürüklenir ve gradyanlar pratik olarak ölür. 1/√d_k ölçeklemesi varyansı tam olarak 1’e geri getirir:
O(N²) Çıkmazı: Kare Matrisin Fiziksel Bedeli
Standart attention implementasyonları (naif PyTorch dahil) S ve P matrislerini tam olarak malzemeleştirir: N×N tam bir matris GPU’nun ana belleğine (HBM/DRAM) yazılır, okunur, üzerine yazılır. Bu, teorik karmaşıklık analizinde “sabit” görünen bir faktörün pratikte nasıl patladığının dersidir.
Sayısal bir ölçek tahmini yapalım. FP16’da bir eleman 2 bayt tutar. Tek bir attention head için P matrisinin bellek ihtiyacı:
| Bağlam uzunluğu N | N² (eleman) | Tek head, FP16 bellek |
|---|---|---|
| 4.096 (klasik GPT-2) | 1,68 × 10⁷ | 33,6 MB |
| 16.384 | 2,68 × 10⁸ | 537 MB |
| 65.536 | 4,29 × 10⁹ | 8,6 GB |
| 131.072 (128k bağlam) | 1,72 × 10¹⁰ | 34,4 GB |
128k token’lık bir bağlamda tek bir head’in olasılık matrisi, 80 GB’lık bir A100’un yarısından fazlasını tek başına yer. Bir modelde onlarca head ve onlarca katman olduğunu, bir de eğitimin geri yayılım için bu tensörleri saklaması gerektiğini düşünürsek, kare matris malzemeleştirmek uzun bağlamda fiziksel olarak imkânsız hale gelir. O(N²) burada asimptotik bir not değil, bir VRAM ölüm cezasıdır.
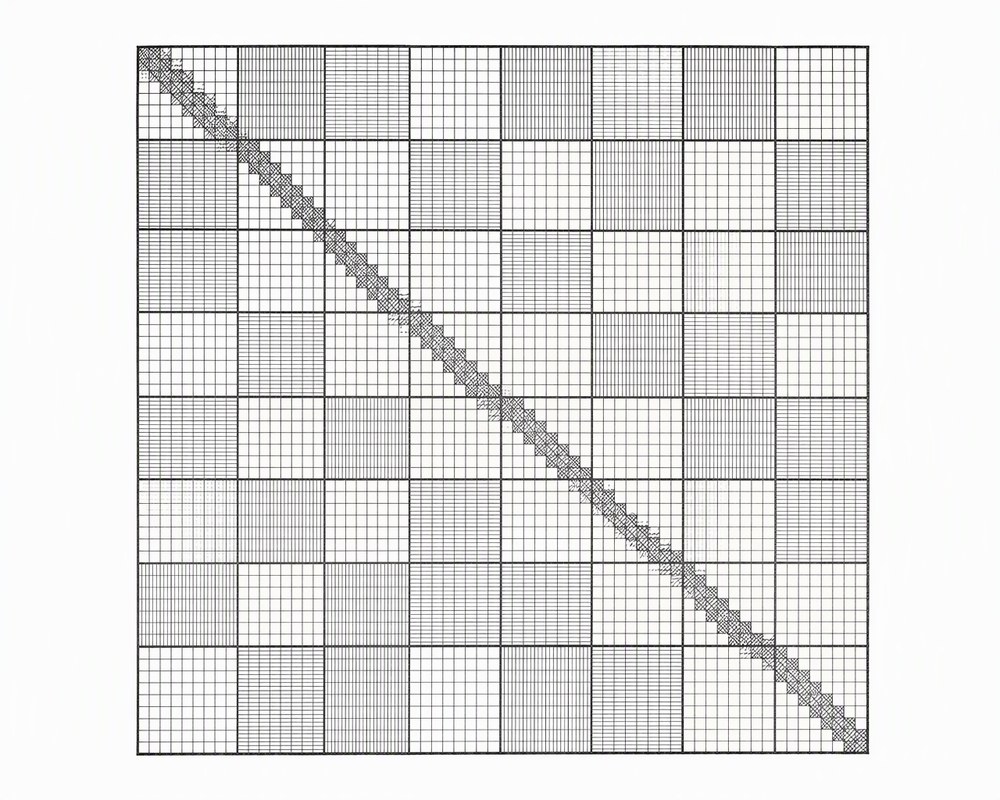
Daha sinsi olan ikinci maliyet ise veri hareketidir (IO). Standart bir forward geçişinde, head başına yaklaşık şu HBM trafiği oluşur:
- Q ve K’nın okunması: 2 × Nd_k eleman
- S’in yazılması: N² eleman
- Softmax için S’in okunması + P’nin yazılması: 2N² eleman
- PV için P’nin okunması: N² eleman
- O’nun yazılması: Nd_k eleman
Toplam: Θ(N² + Nd_k) ≈ Θ(N²) HBM erişimi — yani hesaplamanın kendisi kadar, hatta bant genişliği kısıtında ondan daha fazla, veri taşıma zorunluluğu.
Bellek Duvarının Fiziği: Neden Hesaplamadan Değil, Taşımaktan Ölüyoruz?
Bellek duvarı (memory wall) terimi, işlemci hızının bellek hızından sistematik olarak çok daha hızlı büyümesi ve aradaki makasın her nesilde açılması olgusunu adlandırır (Wulf & McKee, 1995). Rakamlarla: 1980’lerden 2010’lara uzanan 30+ yıllık pencerede tepe kayan-nokta hesap hızı ortalama yılda ~%52-60 büyürken, DRAM bant genişliği yalnızca yılda ~%10, DRAM gecikmesi ise neredeyse hiç iyileşmeden ilerledi (Patterson, IAS 2013). Yani bugün bir GPU’nun transistörleri, veriyi kendisine taşıyabileceğiniz hızdan kat kat fazla sayıda çarpma yapabilecek durumdadır.
Bu dengesizliği ölçen standart araç roofline modelidir (Williams, Waterman & Patterson, 2009). Bir çekirdeğin ulaşabileceği performans, iki duvarın altındaki en iyidir:
Burada πtepe tepe FLOP/s, β bant genişliği (byte/s) ve I = FLOP/byte ise iş yükünün aritmetik yoğunluğu (arithmetic intensity). İki duvarın kesiştiği sırt noktası (ridge point) kritik bir eşiktir; altında bellek-bağlı (memory-bound), üstünde hesap-bağlı (compute-bound) çalışırsınız.
NVIDIA A100 (SXM4, 40 GB) ile somutlaştıralım:
- Tepe FP16 Tensor çekirdeği hesabı: πtepe ≈ 312 TFLOP/s
- HBM2e bant genişliği: β ≈ 1.555 TB/s (40 GB model; 80 GB SXM modelde ~2.0 TB/s)
- Sırt noktası: 312 × 10¹² / 1.555 × 10¹² ≈ 200 FLOP/byte
Şimdi standart attention’ın forward IO bütçesini aritmetik yoğunluğa çevirelim. Matris çarpımları 4N²d_k FLOP üretir; Θ(N²) mertebesindeki ana matris trafiği (S yazımı + S/P okuma-yazma geçişleri ≈ 4N² eleman) FP16’da ~8N² bayt taşır. Kaba ama dürüst bir oran:
Tipik d_k = 128 için I ≈ 64 FLOP/byte — A100’ün sırt noktası olan ~200’ün belirgin şekilde altında. Softmax’ın eleman-bazlı geçişleri ise daha da kötüdür: satır maksimumu, üstel ve toplam gibi işlemler bayt başına yalnızca birkaç FLOP yapar (I ≈ 1 mertebesinde) ve saf bellek-bağlıdır. Sonuç: attention, GPU’nun hesaplama gücünü asla doyuramaz; çekirdekler veri bekler.
Zaman tahmini de aynı şeyi söyler. N = 16.384, d_k = 128, tek head, FP16 için:
- Matris çarpımlarının tepe-hesap süresi: 4N²d_k / 312×10¹² ≈ 0,44 ms
- Yaklaşık Θ(N²) HBM trafiğinin süresi: 8N² bayt / 1,555×10¹² ≈ 1,38 ms
Yani saf IO, saf hesabın üç katı — ve bu, softmax’ın eleman-bazlı maliyetlerini ve geri yayılımı hiç saymadan. Standart attention bir hesaplama problemi değil, bir veri taşıma problemidir. FlashAttention’ın tüm dehası, bu cümlenin farkında olmasıdır.
Softmax’ın Kalesi: Neden Blok Blok Parçalanamaz Görünüyor?
Bir matris çarpımını bloklara ayırmak rutindir; tiling, GPU mimarisinin doğasında vardır. Softmax ise satır-özgün (row-coupled) bir normalizasyon operatörüdür ve bu, tiling’i ilk bakışta imkânsız kılar. Tanım gereği softmax:
Paydadaki toplam, satırın tüm elemanlarını gerektirir. Skor matrisinin bir bloğunu SRAM’de hesaplayıp HBM’e yazmadan geçmek isterseniz, o bloğun nihai ağırlığını bilemezsiniz — çünkü normalleştirme sabiti henüz tamamlanmamıştır.
İkinci sorun sayısal kararsızlıktır. FP32’de en büyük temsil edilebilir sayı ~3,4×10³⁸ olduğundan ex yaklaşık x > 88,7’de taştığında sonsuza (inf) döner; FP16’da bu eşik e11 civarındadır ve çok daha erkendir. Standart stabilite hilesi, her satır için maksimum değerini çekmektir:
Bu dönüşüm matematiksel olarak değişmezdir (pay ve paydaya aynı e−m çarpanı gelir) ama satırın tamamını görmeden m’yi hesaplayamazsınız. İşte kilit düğüm: tam satır görmek istiyorsanız Θ(N²) bellek malzemeleştirmeniz gerekir; malzemeleştirmemek istiyorsanız normalizasyonu ertelemeniz gerekir.
Online Softmax: Normalizatörü İstemci (Streaming) Hesaba Çevirmek
Düğümü çözen fikir, Milakov & Gimelshein’in (2018) “online normalizer calculation for softmax” çalışmasında formelleşen ve Milikic/Dao hattında attention’a taşınan gözlemdir: softmax’ın istatistikleri (maksimum ve toplam) bir özyineleme (recurrence) ile adım adım güncellenebilir.
Satırı B bloğa ayırın, her bloğun kendi maksimumu m̃b ve blok-toplamı ℓ̃b olsun. Yürüyen (running) maksimum m ve yürüyen toplam ℓ tutarak blokları sırayla eritin:
İlk terim, önceki blokların eski maksimum referansına göre birikmiş toplamunu yeni maksimuma yeniden ölçekler; ikinci terim yeni bloğun katkısıdır. Tümevarımla kanıt tek satırdır: her adımda ℓb = Σi ≤ blok b ex_i − m_b korunur; son blokta m_B = m (global maksimum) ve ℓ_B = Σi ex_i − m olur — yani tamamen klasik, sayısal olarak stabil softmax ile bit-bazında aynı sonuç. Yaklaşıklık yoktur; yalnızca sıralama farkı vardır.
Aynı özyineleme, paydadaki toplamla birlikte biriktirilen ağırlıklı çıktı toplamına da genelleştirilebilir — ki FlashAttention’ın istediği tam olarak budur. Bir de pratik bir donanım detayı: GPU’lar için en hızlı üstel talimatı doğal tabanlı exp değil, exp2’dir. Bu yüzden FlashAttention, skorları 1/(√d_k · ln 2) ile ön-ölçekler ve tüm üstelleri exp2 cinsinden yazar; ln 2 sabiti yürüyen istatistiklerin ölçeklemesine aynı şekilde taşınır. Sonuç, değişmez bir matematiksel özdeşliktir: ex = 2x·log₂e.
FlashAttention: SRAM’İ Algoritmanın Tasarım Dili Yapmak
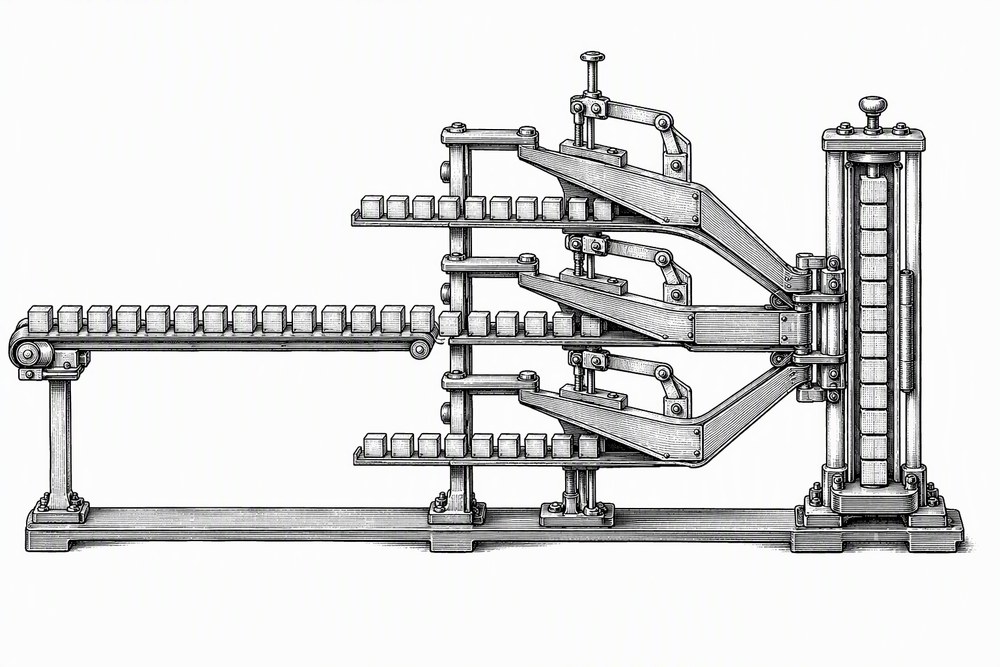
Dao ve arkadaşlarının 2022’de tanıttığı FlashAttention, yukarıdaki iki parçayı — tiling ve online softmax — GPU bellek hiyerarşisinin fiziksel gerçekleriyle birleştiren IO-ağırı (IO-aware) tam bir attention algoritmasıdır. Anahtar ilke şudur:
N×N skor matrisi HBM’e asla yazılmaz. Her şey, çip üzerindeki hızlı SRAM’de (paylaşılan bellek / L1, A100’de SM başına ~192 KB, tüm çip ölçeğinde ~20 MB) olur biter; HBM ile SRAM arasındaki tek trafiği Q, K, V ve O gibi Θ(Nd) boyutundaki girdi/çıktılar taşır.
Forward geçişin iskeleti
Q ∈ ℝN×d satır bloklarına (Boyut Br), K, V ∈ ℝBc×d sütun bloklarına bölünür. Dış döngü K/V blokları, iç döngü Q blokları üzerinde döner (v1’in seçimi; v2’te swap edilir). SRAM’de her adım için şunlar barındırılır:
- Q̃ (Br×d), K̃ (Bc×d), Ṽ (Bc×d) girdi blokları
- Ara skor bloğu S̃ = Q̃K̃T (Br×Bc)
- Yürüyen istatistikler: satır maksimumu m ∈ ℝB_r, yürüyen toplam ℓ ∈ ℝB_r, yürüyen çıktı biriktirici Õ ∈ ℝB_r×d
Bloğun çekirdek güncellemesi (satır bazında, vektörel):
Tüm bloklar bitince tek bir normalizasyon: O = diag(ℓ)−1·Õ. P matrisi hiçbir zaman tam olarak var olmaz; yalnızca SRAM’de doğar, katkısını Õ’ya verir ve ölür.
Blok boyutları SRAM kapasitesi M (eleman cinsinden) ile kısıtlanır: Q̃, K, Ṽ blokları ve Br×Bc ara tamponlarının toplamı M’i aşmamalıdır. Makalenin pratik seçimi kabaca Br ≈ ⌈M/(4d)⌉, Bc ≈ ⌈M/(4Br⌉) civarındadır — yani d ve M verildiğinde bloklar, dört ana SRAM nesnesinin (Q̃, K̃, ve S̃/Õ tamponları) eşit dilimlere ayrılmasından türetilir.
IO karmaşıklığı ve optimallik kanıtı
FlashAttention’ın teorem düzeyinde iddiası, HBM-SRAM arasındaki toplam veri hareketinin:
olmasıdır; burada d = d_k, M = SRAM kapasitesi. Standart attention’ın Θ(N²) trafiğine oranı d²/M faktörüdür: d = 64 için bu, N×N matrisin bir daha asla HBM’e dokunmaması sayesinde gelen ~d² katlık bir kazanımdır. Dahası makale, bu trafiğin alt sınır olduğunu da kanıtlar: klasik Red-Blue pebble-game tekniğiyle (Hong & Kung, 1981) herhangi bir tam (exact) attention algoritmasının Ω(N²d²/M) HBM erişimi yapmak zorunda olduğu gösterilir. Yani FlashAttention IO anlamında optimaldir; ondan daha az veri taşıyan bir tam attention algoritması (modelleme varsayımları altında) var olamaz.
Hesap tarafında ise iş değişmez: runtime O(N²d) FLOP’tur ve makale, d ≳ log N iken herhangi bir tam attention algoritmasının Ω(N²) sürenin altına inemeyeceğini de kanıtlar. FlashAttention hızı azaltmaz; bellek duvarını aşar.
Kağıt üzerindeki sonuçlar
FlashAttention (v1) makalesinin raporladığı, standart implementasyonlara kıyasla: BERT-large eğitiminde %15, GPT-2’de 3× hızlanma; GPT-2’de 2× daha uzun dizilerle %15 daha düşük perplexity; Long Range Arena’da 2,4× daha uzun dizilere çıkabilme. Bunlar yaklaşım (approximation) içermeyen, matematiksel olarak standart attention ile aynı çıktıyı üreten bir algoritmanın kazançlarıdır — ilk kez “daha akıllı yaklaşık attention” değil, aynı attention ama IO-ağırlıklı mümkündür.
Geri Yayılım: Hesabı Unutup Yeniden Kurmak (Recomputation)
Eğitimde asıl bellek maliyeti forward aktivasyonlarının saklanmasıdır: standart attention, geri yayılım için S ve P’yi (Θ(N²)) saklamak zorundadır. FlashAttention’ın geri geçişi bunun yerine yeniden hesaplamayı (recompute) seçer — çünkü hesabın marjinal maliyeti ucuz, veri taşımanınki pahalıdır.
Saklanan tek şey, satır başına iki sayıdır: çıktı O ve log-sum-exp istatistiği:
Böylece forward aktivasyon belleği Θ(N²)‘den Θ(N)‘e düşer. Geri geçişte, saklı L ve dO (başlangıç gradyanı) kullanılarak her P bloğu SRAM’de anında yeniden üretilir: P = exp(S − L) (satır bazında). Gradyan formülleri:
Bu, softmax’ın klasik gradyan özdeşliğinin (d softmax = p ⊙ (dp − ⟨dp⟩)) bloklara ve yeniden ölçeklemeye uyarlanmış halidir; D vektörü, normalizasyon teriminin satır bazlı toplamını temsil eder ve bir forward çıktısı olarak O’dan bedavaya hesaplanır. Toplam FLOP bütçesi forward’a ek ~2 kat daha yeniden hesap içerir (pratikte ~2,5 kat) — ama bu FLOP’lar SRAM’de, bant genişliği duvarına çarpmadan harcandığı için duvar saati (wall-clock) süresi yine de belirgin şekilde kısalır.
FlashAttention-2 ve -3: Utilizasyon Savaşı
Algoritma bir kez IO-optimal olduktan sonra geriye kalan kayıp, GPU’nun içindeki mikro mimari sürtünmelerdir: matris çarpanı olmayan (non-matmul) CUDA çekirdek işleri, yetersz paralellik ve yarı-tel (warp) senkronizasyonu.
FlashAttention-2 (Dao, 2023) üç mühendislik darbesiyle FA1’i ~2× hızlandırır ve A100’de tepe FP16 kapasitenin ~%73’üne kadar çıkar:
- Döngü takası: Dış döngü Q blokları üzerinde döner; böylece farklı bloklar farklı thread-block’lara (ve GPU’lara/sequence’e) paralel dağıtılabilir — uzun dizilerde ve batch=1 eğitiminde darboğaz kırılır.
- Non-matmul FLOP azaltımı: Yürüyen normalizasyonun bölme ve yeniden ölçekleme işleri iç döngüden çıkarılıp en sona ertelenir; biriktirici Õ, içeride normalize edilmeden toplanır.
- Daha iyi warp bölümlemesi: Her warp, paylaşılan bellek üzerinden senkronize edilen sütun dilimleri yerine kendi K/V dilimini işler; SRAM’den register’lara giden trafiği ve senkronizasyon sayısı azalır.
FlashAttention-3 (Shah ve ark., 2024) ise NVIDIA Hopper (H100) mimarisinin asenkron birimlerine özel yazılır: WGMMA (warp-group matris çarpma) birimlerinin hesap yaparken, TMA (Tensor Memory Accelerator) birimlerinin veriyi paralel taşıması için üretici/tüketici (producer/consumer) warp-specialization iskeleti kurulur; yazılım boru hattı (software pipelining) ile GEMM ve softmax’ın üstel/skala işleri eşzamanlı (overlap) çalışır — Hopper’ın asenkron matris birimleri bunu ilk kez mümkün kılar. Sonuç: FP16’da H100’de FA2’ye göre ~1,5-2× hız ve tepe kapasitenin ~%75’ine varan SM utilisasyonu (ileri geçişte ~740 TFLOP/s mertebesi); FP8’de ise bloklar-arası ölçekleme ve “incoherent processing” (işaret rastgele çarpanları) ile hassasiyet kaybı bastırılarak ~1,2 PFLOP/s mertebesinde çıkar.
Bu üç neslin ortak mesajı şudur: asimptotik karmaşıklık aynı kalırken (Θ(N²d) hesap), sabit faktörler donanımın fiziksel dilini konuşarak ~10× mertebesinde sıkıştırılabilir.
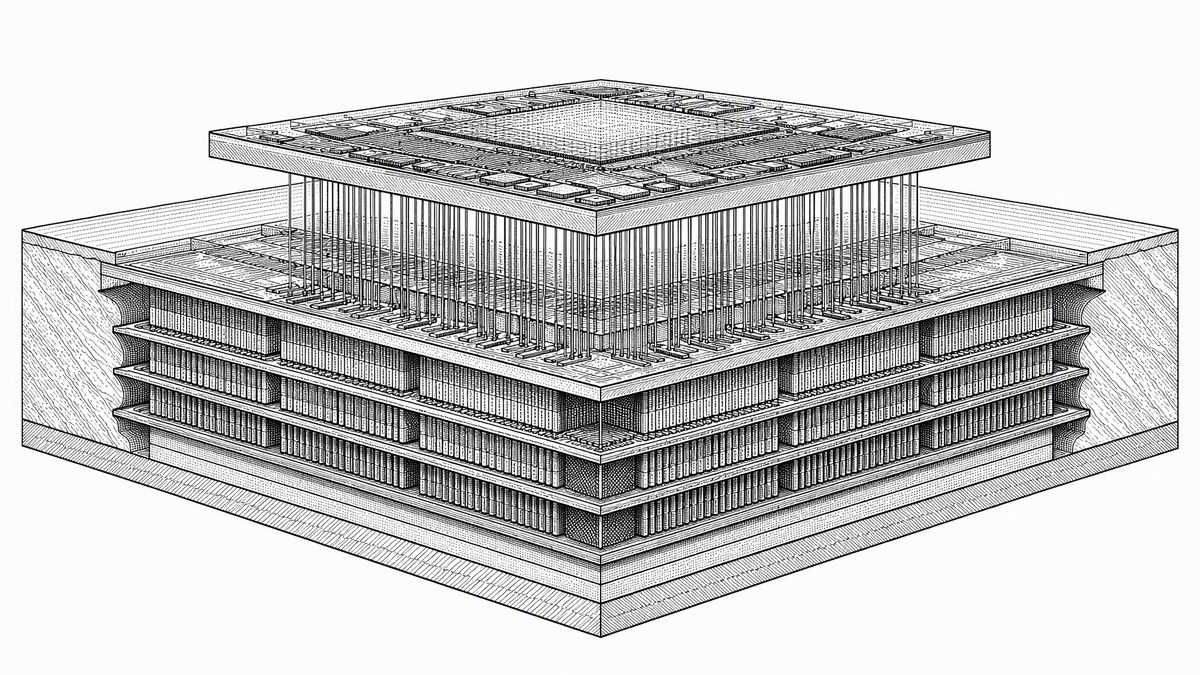
Fiziksel Katman: SRAM Hücrelerinden HBM Yığınlarına
Algoritmanın neden SRAM’e sığındığını anlamak için hücre fiziğine inmek gerekir. GPU’nun on-chip belleği 6T SRAM’den oluşur: çapraz bağlı iki eviriciden (inverter) oluşan dört transistör bir bit’i kilitler, iki erişim transistörü (access transistor) ise kelime satırı (wordline) işaretinde hücreyi bit satırlarına (bitline) bağlar.
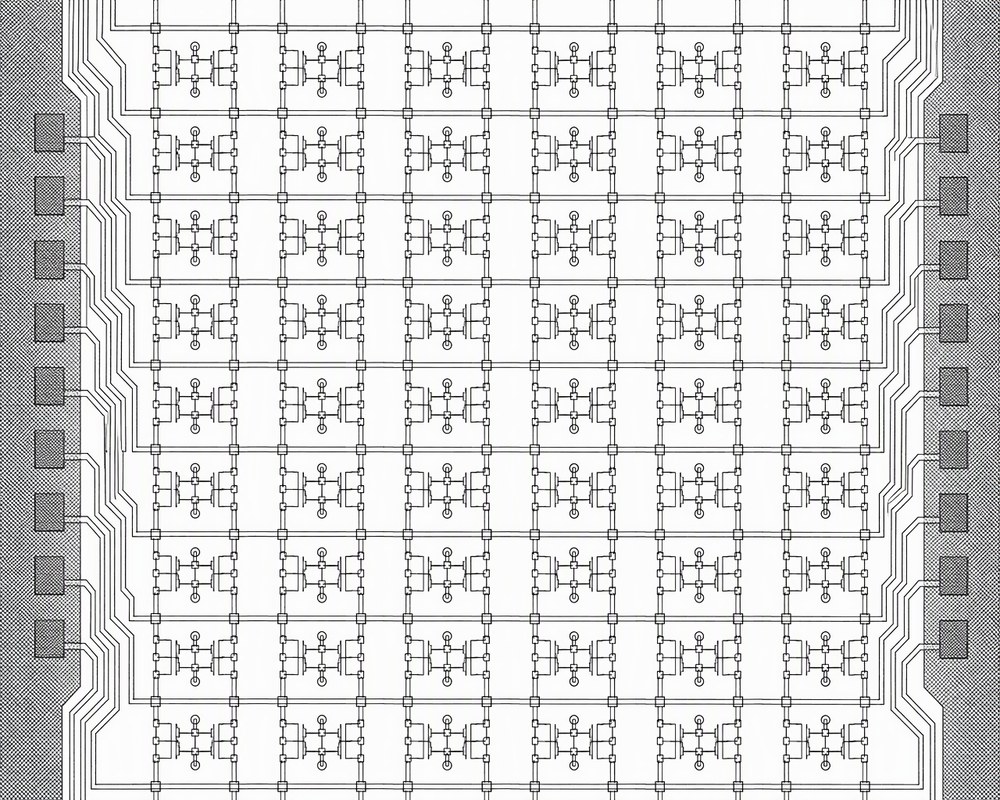
Hücre başına altı transistör, SRAM’i hacim başına pahalı yapar; DRAM’in tek-transistör + tek-kapasitör (1T1C) hücresiyle yoğunluk yarışamaz. Ama bedeli ödenen şey hızdır: refresh döngüsü yoktur, erişim nanosaniyenin de altındadır ve A100’de ~20 MB’lık toplam SRAM’ın agregat bant genişliği ~19 TB/s mertebesindedir — HBM’in ~12 katı. HBM tarafında ise kapasite bol ama mesafe uzundur: DRAM çekirdekleri silisyum ara-yüzeyine dikey olarak (TSV, through-silicon via) yığılır, paket başına geniş bir arayüzle çipe bağlanır; 40-80 GB’lık alanın bedeli, saniyede ~1,5-2 TB’la tavan yapan bir boru hattıdır.
Kısır döngünün özeti: Çipin üretebildiği hesap, çipin beslenebildiği veriden çok daha hızlı büyüyor. FlashAttention bu eşitsizliği bir algoritma aksiyomu olarak kabul eder ve Θ(N²d²/M) formülündeki M’i —yani SRAM’i— algoritmanın birinci sınıf vatandaşı yapar.
Duvarın Ötesi: KV Cache, Uzun Bağlam ve Yaklaşık Attention
FlashAttention, eğitim ve tekil attention hesabının IO duvarını yıkır; ancak çıkarım (inference) sırasında başka bir Θ(N) bellek nesnesi sahneye çıkar: KV cache. Otoregresif üretimde her yeni token, geçmiş tüm tokenların K ve V tensörlerini yeniden hesaplamamak için önbelleğe alınır. Katman başına cache boyutu:
Örnek: 32 katmanlı, d_model = 4096’lık 7B sınıfı bir modelde FP16 ile token başına 2 × 4096 × 32 × 2 bayt ≈ 0,52 MB; 4096 token’lık bir oturum ≈ 2,1 GB. Bağlam uzadıkça KV cache, batch ölçeğinde HBM’i yeniden kuşatır — bu yüzden PagedAttention (vLLM), gruplandırılmış-kuyruk attention (GQA/MQA) ve MLA gibi yöntemler attention’ın IO probleminin çıkardıma özgü ikinci cephesini hedefler.
Alternatif hat ise O(N²)‘yi asimptotik olarak kırmaya çalışan yaklaşık/lineer attention aileleridir (Performer’ın hatırı sayılır özellik yaklaşımı, Linformer’ın düşük-rank projeksiyonu, state-space modellerinin tamamen attention-dışı geçişi). FlashAttention’ın konumu burada nettir: kalite ödünü vermeden mevcut kaliteyi üretenleri hedefleyen, tam sonuç üreten bir IO optimizasyonudur — ve tam da bu yüzden pratikte endüstri standardı olmuştur.
Sonuç: Asimptotik Yeterli Değil, Fiziksel Okuryazarlık Şart
Bu makalenin taşıdığı tek bir mühendislik dersi varsa o da şudur: bir algoritmanın bellek karmaşıklığını hesaplama karmaşıklığından ayrı tasarlamayan her optimizasyon, bellek duvarına çarpmaya mahkumdur. Self-attention’ın O(N²) laneti on yıl boyunca “daha az FLOP” ekseninde çözülmeye çalışıldı; kırılma, FLOP’u hiç azaltmadan yalnızca veri hareketini Θ(N²)‘den Θ(N²d²/M)‘ye indiren bir IO-ağırı tasarımla geldi. Online softmax, satırı bütün olarak görme zorunluluğunu bir özyinelemeye; tiling, o özyinelemeyi SRAM’in fiziksel diline çevirdi.
Principia’nın açılış ilkesi budur: Sayılar yalan söylemez; formüller eskimez. Bir sonraki yazıda, bu kez bellek hiyerarşisinin diğer ucuna — HBM’in kendisine ve çipler-arası ölçeklemenin IO fiziğine — ineceğiz.
Kaynaklar
- Vaswani ve ark., Attention Is All You Need, NeurIPS 2017 — arxiv.org/abs/1706.03762
- Dao, Fu, Ermon, Rudra, Ré, FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, NeurIPS 2022 — arxiv.org/abs/2205.14135
- Tri Dao, FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, ICLR 2024 — arxiv.org/abs/2307.08691
- Shah, Bikshandi, Zhang, Thakkar, Ramani, Dao, FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision, NeurIPS 2024 — arxiv.org/abs/2407.08608
- Milakov & Gimelshein, Online Normalizer Calculation for Softmax, NVIDIA 2018 — arxiv.org/abs/1805.02867
- Wulf & McKee, Hitting the Memory Wall: Implications of the Obvious, ACM CCR 1995
- Williams, Waterman & Patterson, Roofline: An Insightful Visual Performance Model for Multicore Architectures, CACM 2009
- Hong & Kung, I/O Complexity: The Red-Blue Pebble Game, STOC 1981
- NVIDIA A100 Tensor Core GPU Mimarisi Beyaz Kağıdı (2020); NVIDIA H100 Tensor Core GPU Beyaz Kağıdı (2022)
Sık sorulan sorular
FlashAttention nedir ve attention'ı nasıl hızlandırır?
FlashAttention, N×N attention skor matrisini ana belleğe (HBM) yazmak yerine GPU'nun çip üzerindeki SRAM'inde (A100'de ~20 MB) bloklar halinde hesaplayan tam (exact) bir attention algoritmasıdır. HBM-SRAM arasındaki veri hareketini Θ(N²)'den Θ(N²d²/M)'ye indirir; hesap karmaşıklığı O(N²d) olarak kalır. BERT-large'da %15, GPT-2'de 3× eğitim hızlanması sağlar ve çıktı matematiksel olarak standart attention ile birebir aynıdır.
Self-attention neden O(N²) bir bellek problemi yaratır?
Her token'ın her token ile skor üretmesi gerektiğinden QK^T çarpımı N×N boyutunda bir matris oluşturur ve naif implementasyonlar bu matrisi tam olarak belleğe yazar. FP16'da tek bir head için 2N² bayt tutan bu matris, 128k token'lık bağlamda yaklaşık 34,4 GB yapar — tek başına bir A100'un yarısından fazlasını tüketir. Asimptotik notasyon değil, fiziksel bir VRAM limiti söz konusudur.
Bellek duvarı (memory wall) nedir?
İşlemci hızının (yılda ortalama %50+ büyüyen FLOPS) bellek bant genişliğinden (yılda ~%10 büyüyen DRAM) sistematik olarak hızlı büyümesidir (Wulf & McKee, 1995). Roofline modelinde iş yükünün aritmetik yoğunluğu (FLOP/byte) sırt noktasının altında kalıysa çekirdekler veri bekler: A100'ün sırt noktası ~200 FLOP/byte iken attention'ın skor geçişi ~d_k/2 ≈ 64 FLOP/byte civarındadır; yani problem hesap değil, veri taşımadır.
Online softmax nasıl çalışır ve neden FlashAttention için şarttır?
Softmax'ın satır geneli gereken maksimum ve toplam istatistiklerini, bloklar halinde yürüyen (running) m ve ℓ değerleriyle özyinelemeli günceller: m_new = max(m_old, blok_maks); ℓ_new = e^(m_old−m_new)·ℓ_old + Σ_blok e^(x−m_new). Yeniden ölçekleme sayesinde sonuç, satırın tamamını görerek hesaplanan klasik stabil softmax ile bit-bazında aynıdır. Bu, N×N matrisi malzemeleştirmeden tile edilmiş attention'ı mümkün kılan anahtardır.
FlashAttention eğitim belleğini ne kadar düşürür?
Standart attention geri yayılım için N×N aktivasyonları saklarken FlashAttention yalnızca çıktı O ve satır başına log-sum-exp skalerini saklar; böylece attention aktivasyon belleği katman başına Θ(N²)'den Θ(N)'e düşer. Karşılığında geri geçişte P blokları SRAM'de yeniden hesaplanır — FLOP ucuz, HBM IO pahalı olduğu için toplam duvar saati süresi kısalır.
Konuyla ilişkili WebTuring analizleri
vLLM Nedir? Üretimde Çıkarım (Inference) Hızı Neden Standart API'lardan 10 Kat Hızlı?
GraphRAG Nedir? Vektör Veritabanları Neden Büyük Şirketlere Yetmiyor?
1 Milyon Token 3 Kuruşa İndi: DeepSeek-V4.1-Flash Bellek Tüketimini 4 Kat Düşürerek Çıktı