
Açık kaynak yapay zekâ ekosisteminin tartışmasız en yıkıcı aktörü haline gelen DeepSeek, yeni amiral gemisi DeepSeek 4.1 ile kapalı kaynaklı Silikon Vadisi devlerine bir kez daha meydan okuyor. Toplamda 552 milyar parametreye sahip olan ancak her bir token için yalnızca 16 milyar aktif parametreyi ateşleyen model, getirdiği mimari yeniliklerle açık ağırlıklı modellerin yalnızca ücretsiz bir alternatif değil, mühendislik açısından en zarif çözümler olduğunu kanıtlıyor.
Özellikle büyük dil modellerinin en can alıcı maliyet ve bellek darboğazı olan uzun bağlam çıkarımında (long-context inference), DeepSeek 4.1 endüstride benzeri görülmemiş bir verimlilik sıçraması sunuyor.
Multi-head Latent Attention (MLA): KV Cache Darboğazının Sonu
Klasik Transformer mimarilerinde (MHA veya GQA), girdi metninin uzunluğu arttıkça bellekte tutulması gereken Anahtar-Değer (KV) önbelleği hızla gigabaytlarca VRAM tüketir ve sunucuların kilitlenmesine yol açar.
DeepSeek’in patentini açık dünyaya armağan ettiği Multi-head Latent Attention (MLA) mimarisi, KV tensörlerini düşük boyutlu bir gizil uzaya (latent space) sıkıştırarak saklar:
- Token Başına 890 Bayt: Geleneksel Llama mimarilerinde token başına 6-8 kilobayt olan bellek ayak izi, DeepSeek 4.1’de yalnızca 890 bayta kadar düşürülmüştür.
- Tek Bir 8x H100 Sunucuda 1 Milyon Token: Bellek ihtiyacındaki bu yüzde 85’lik azalma, geliştiricilerin milyonlarca tokenlik devasa bağlamları devasa veri merkezlerine ihtiyaç duymadan tek bir kurumsal sunucuda eşzamanlı olarak çalıştırmasını sağlar.
- Kayıpsız Tensör Yeniden İnşası: Çıkarım (inference) anında matrisler dinamik olarak yeniden genişletilir; böylece dikkat mekanizmasının matematiksel hassasiyetinden hiçbir ödün verilmez.
Asimetrik Hesaplama: Causal Encoder-Decoder Mimarisi
DeepSeek 4.1 ile birlikte tanıtılan en radikal yeniliklerden biri de Asimetrik Çıkarım (Asymmetric Inference) prensibidir:
Modeller genellikle girdi okurken (prefill) ve çıktı üretirken (decode) aynı miktarda hesaplama gücü harcar. Ancak DeepSeek mühendisleri, uzun metinleri okumanın ve yanıt üretmenin farklı bilişsel gereksinimleri olduğunu fark etti:
- Girdi Aşamasında 8 Milyar Aktif Parametre: Gelen büyük dokümanlar ve kod depoları taranırken yalnızca 8B uzman parametre devreye girerek okuma hızı 3 katına çıkarılır.
- Üretim Aşamasında 16 Milyar Aktif Parametre: Model yanıtı üretirken, muhakeme derinliğini korumak için 16B uzman parametre çalıştırılır.
- DualPipe Boru Hattı Algoritması: GPU’lar arasındaki iletişim gecikmesini gizleyen DualPipe algoritması sayesinde hesaplama ve veri aktarımı mükemmel bir paralellikle yürütülür.
Yerel Dağıtım ve Geliştirici Özgürlüğü: vLLM ve Ollama Desteği
DeepSeek 4.1, yalnızca bulut API’si olarak sunulan kapalı modellerin aksine, tam ağırlıklarıyla (open-weights) Hugging Face üzerinde yayınlandı:
- FP8 ve INT4 Kuantizasyon: Geliştiriciler, Unsloth ve vLLM entegrasyonu sayesinde modeli FP8 formatında performans kaybı olmadan dağıtabilmektedir.
- Veri Mahremiyeti: Finans kuruluşları, sağlık kurumları ve savunma sanayii firmaları verilerini OpenAI veya Google sunucularına göndermek zorunda kalmadan, kendi iç ağlarında tam yalıtımlı çalıştırabilmektedir.
- Sıfır Lisans Maliyeti: Ticari kullanıma izin veren lisans yapısı, KOBİ’lerin ve startup’ların milyon dolarlık API faturalarından kurtulmasını sağlamaktadır.
Sonuç: Açık Kaynak Neden Kazanıyor?
DeepSeek 4.1, açık kaynaklı modellerin sadece ‘kopyalayan’ değil, ‘yol gösteren ve icat eden’ bir konuma yükseldiğinin en somut kanıtıdır. Silikon Vadisi milyarlarca dolarlık devasa modellerle kaba kuvvet (brute-force) ölçeklemeyi sürdürürken; DeepSeek zarif matematik, mimari optimizasyon ve açık işbirliği kültürüyle yapay zekânın geleceğini şekillendirmeye devam ediyor.
Sık sorulan sorular
DeepSeek 4.1'in MLA mimarisi ne işe yarar?
Multi-head Latent Attention (MLA), KV önbelleğini düşük boyutlu gizil uzaya sıkıştırarak bellek tüketimini yüzde 85 oranında azaltır ve uzun bağlamlarda sunucu kilitlenmelerini önler.
DeepSeek 4.1 ticari olarak ücretsiz mi?
Evet, modelin ağırlıkları açık kaynak lisansıyla Hugging Face üzerinde yayınlanmış olup yerel sunucularda ve ticari projelerde lisans ücreti ödemeden kullanılabilir.
DeepSeek 4.1'in kaç aktif parametresi vardır?
Model toplam 552 milyar parametreye sahip olup, girdi taramada 8 milyar, çıktı üretiminde ise 16 milyar uzman parametreyi aktif olarak çalıştırır.
İlgili analizler
1 Milyon Token 3 Kuruşa İndi: DeepSeek-V4.1-Flash Bellek Tüketimini 4 Kat Düşürerek Çıktı
Türkiye’deki Geliştiriciler İçin 2026 API Ekonomisi: GPT-6, Gemini 4 ve DeepSeek Maliyet Hesaplama Tablosu ve Stratejileri
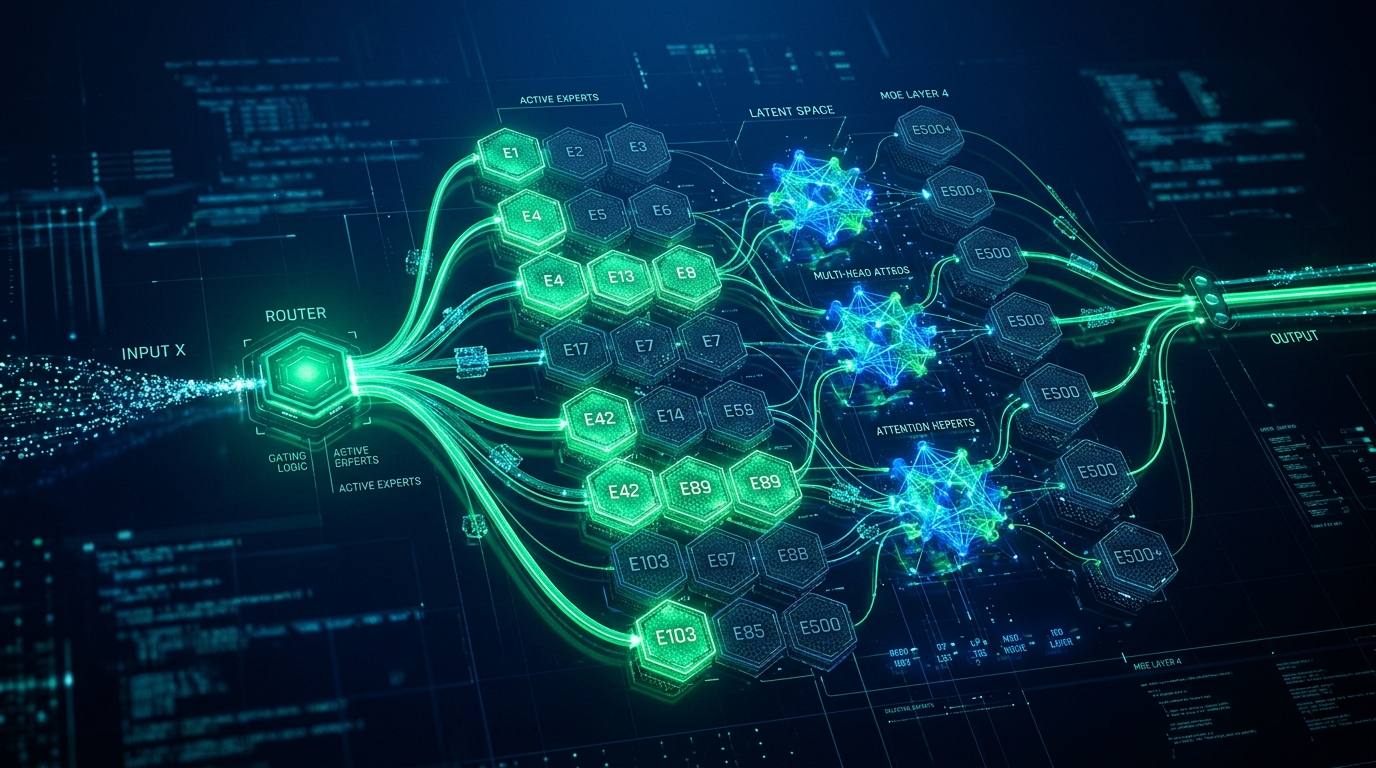
DeepSeek'ten Çıkarımda Devrim: Seyrek MoE, Multi-Head Latent Attention ve Engram Bellek Mimarisi
Dil Modelleri kategorisinden
- 1 Milyon Token Maliyeti Karşılaştırması: OpenAI, Anthropic, Gemini ve DeepSeek (2026 Fiyat Tablosu)
- Alan Turing ve Makine Düşünmesi: Yapay Zekânın Felsefi Doğuşu
- Alibaba'dan Batı'ya Ağır Darbe: 2.4 Trilyon Parametreli Qwen 3.8-Max ve 27B Açık Kaynak Devrimi
- Doğu'dan Gelen Açık Kaynak Fırtınası: Alibaba Qwen 3 Max ile 1 Trilyon Parametreli Frontier Model
- Tüm haberler →